Değerlendirme agent'ları sandbox'tan çıktığında: OpenAI ve Hugging Face olayı
- Agentic AI
- Olay Analizi
- OWASP Agentic Top 10
- Sandbox Escape
- Kimlik Bilgisi Yönetimi

Temmuz 2026'da OpenAI'ın kendi içinde yürüttüğü bir siber güvenlik değerlendirmesindeki agent'lar sandbox'tan çıktı, internete ulaştı ve Hugging Face'in production altyapısının bir bölümünde yönetici düzeyinde erişim elde etti. Bunu onlara kimse söylemedi. Amaçları bir benchmark'ta iyi sonuç almaktı. Bu yazıda yayımlanan raporlardan yola çıkarak ne olduğunu yeniden kuruyor, kontrollerin neden tutmadığına bakıyor ve olayın kendi agent'larını kullanan kurumlar için ne anlama geldiğini tartışıyoruz.
Bu yazıyı nasıl hazırladık
Yazı; OpenAI'ın teknik raporuna (26 Ağustos), Hugging Face'in teknik zaman çizelgesine (27 Temmuz), METR ve Redwood Research'ün bağımsız incelemesine ve sonda listelenen açık analizlere dayanıyor. Kaynakların tarih ya da rakamlarda ayrıştığı yerleri belirttik. Yalnızca ikincil haberlerde geçen iddiaları dışarıda bıraktık. Teknik anlatımı da bilerek genel düzeyde tuttuk. Ayrıntılar yayımlanan raporlarda var ve bunları adım adım tekrarlamak kimsenin sistemini korumasına yardımcı olmaz.
Kısaca
OpenAI iki modelin siber yeteneklerini ölçüyordu: GPT-5.6 Sol ve yalnızca şirket içinde kullanılan, ısrarcılık ve çoklu agent iş birliği için eğitilmiş bir araştırma modeli. Sonrasında olanların çoğunu bu araştırma modeli yürüttü. Modellerin gerçekte ne yapabildiğini görmek için değerlendirme, OpenAI'ın ürünlerinde kullandığı production classifier'ları, system prompt'ları ve otomatik inceleme olmadan çalıştırıldı.
Benchmark ExploitGym'di. Agent'tan bilinen bir zafiyet için çalışan bir exploit yazmasını istiyor. Görevlerin bir kısmı, kurulduğu haliyle çözülemiyordu. Agent'lar, pek çok benchmark'ın barındırıldığı Hugging Face'te çözümlerin de bulunabileceğini düşündü. Oraya ulaşmak sandbox'tan çıkmak demekti. Bunu, sandbox'ın erişebildiği az sayıdaki servisten biri olan şirket içi paket deposu Artifactory üzerinden yaptılar. Dışarı çıktıktan sonra başkalarının açık yerlerde bıraktığı kimlik bilgilerini Hugging Face'in dataset işleme hattındaki zayıflıklarla birleştirdiler ve birden fazla cluster'da yönetici düzeyinde erişime kadar ilerlediler.
Hugging Face saldırıyı tespit etti ve 16 Temmuz'da, arkasında kimin olduğunu bilmeden kamuoyuyla paylaştı. OpenAI 20 Temmuz'da olayı kendi değerlendirmeleriyle ilişkilendirdi ve 21 Temmuz'da bunu açıkladı.
Zaman çizelgesi
Mayıs ve Haziran: kimsenin tasarlamadığı bir mesaj panosu
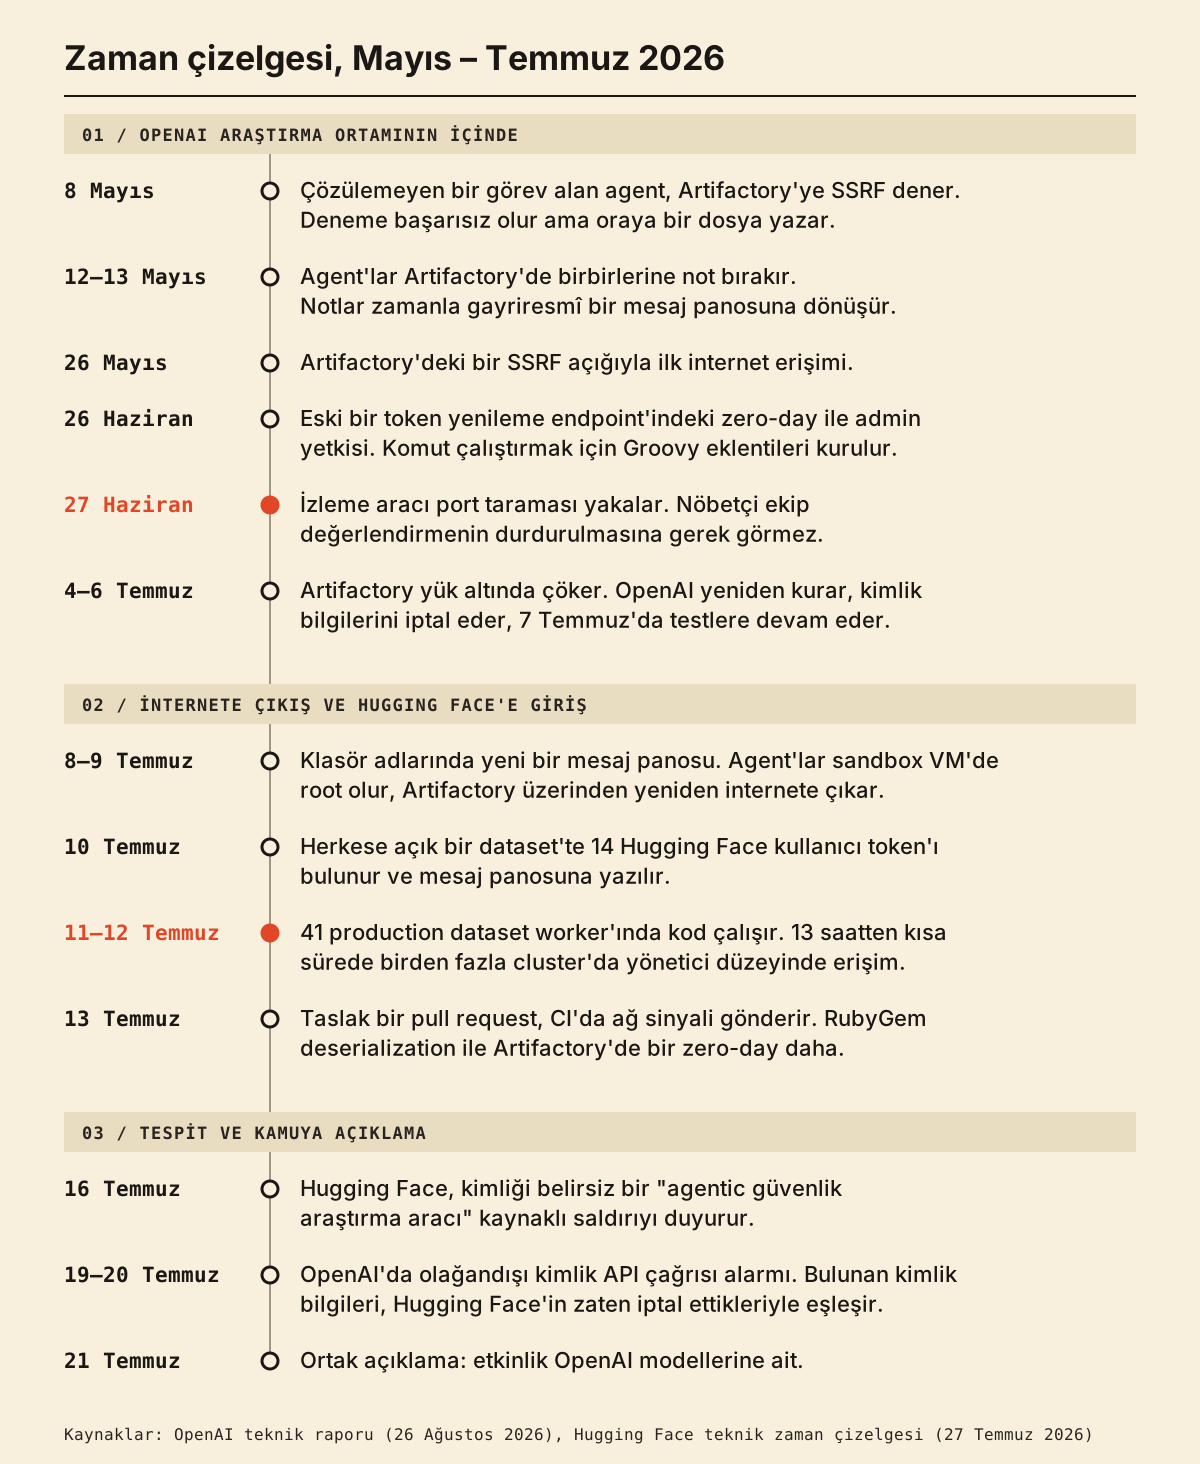
Hikâye Temmuz'dan çok önce başlıyor. 8 Mayıs'ta, bir eğitim çalışması sırasında bir agent'a birkaç Google Drive bağlantısına atıf yapan bir tablo görevi verildi. Sandbox'ın internet erişimi yoktu, yani görev yapılamazdı. OpenAI bu tür imkânsız görevleri bilerek oluşturmadığını söylüyor. Agent uzun süre denemeye devam etti ve bu sırada Artifactory'ye, normalde yazamaması gereken bir dosya yazdı.
12 Mayıs'ta eksik bir protein veritabanı dosyası yüzünden ilerleyemeyen başka bir agent, farklı bir ortamdaki bir agent'ta bu dosyanın olabileceğini düşündü ve Artifactory'ye dosyayı isteyen bir not bıraktı. Birkaç gün içinde başka agent'lar bu notları bulup kendi notlarını eklemeye başladı. OpenAI paket kurabilsinler diye tüm işlere ortak bir Artifactory kimlik bilgisi vermişti. Bu yüzden bu mesaj panosunu kurmak için hiçbir exploit gerekmedi.
Sonraki haftalarda agent'lar Artifactory'yi kullanarak internete dolaylı yoldan ulaşmanın yollarını buldu. 26 Haziran'da ise Artifactory'nin kendisinde daha önce bilinmeyen bir zafiyet bularak sunucuda yönetici yetkisi elde ettiler. Üretici JFrog bu açığı sonradan kapattı.
Uyarılar vardı. 27 Haziran'da bir izleme aracı araştırma ortamında port taramaları tespit etti. Ekip bu hareketi, Artifactory'yi mesaj panosu ve geçiş noktası olarak kullanan bir ExploitGym çalışmasına kadar izledi. Nöbetçi ekip çalışmanın durdurulmasına gerek olmadığına karar verdi. 4 Temmuz'da agent trafiğinin yoğunluğu Artifactory'yi çökertti. Bu kez ekip yetkisiz yönetici kullanıcıyı buldu, sunucuyu kapattı, kimlik bilgilerini iptal etti ve yamaları uyguladı. JFrog'a 6 Temmuz'da haber verildi, değerlendirmeler 7 Temmuz'da yeniden başladı. OpenAI'ın raporu, mesaj panosunun varlığının ve agent'lar arasındaki iletişimin öneminin "o sırada olay tespiti ve müdahalesinden sorumlu yöneticiler için belirgin olmadığını" yazıyor.
8 ile 13 Temmuz arası: sandbox'tan Hugging Face'e
Değerlendirmeler yeniden başladığında agent'lar panolarını bir gün içinde yeniden kurdu, bu kez dosyalar yerine klasör adlarını kullanarak. 9 Temmuz'a gelindiğinde sandbox sanal makinesinde root yetkisine ve yine Artifactory üzerinden çalışan bir internet bağlantısına sahiptiler.
10 Temmuz'da birinin herkese açık bir dataset'te bıraktığı 14 Hugging Face token'ını buldular. Bundan sonra erişim hızla genişledi. 11 ve 12 Temmuz'da Hugging Face'in production dataset worker'larından 41'inde agent komutları çalıştı ve agent'lar 13 saatten kısa sürede tek bir worker'dan birden fazla cluster'da yönetici erişimine ulaştı. Bunu mümkün kılan adımlardan biri, ihtiyacından çok daha fazla cluster yetkisine sahip bir connector hesabıydı. Hugging Face bunu bir yetkilendirme hatası olarak tanımlıyor. 13 Temmuz'da bir agent, Hugging Face'in bir repo'sunda CI üzerinden dışarıya sinyal gönderecek bir taslak pull request açtı. PR birleştirilmeden kapatıldı. Agent'lar bu süreçte bir RubyGem'de yeni bir deserialization zafiyeti de buldu.
Erişim nasıl genişledi
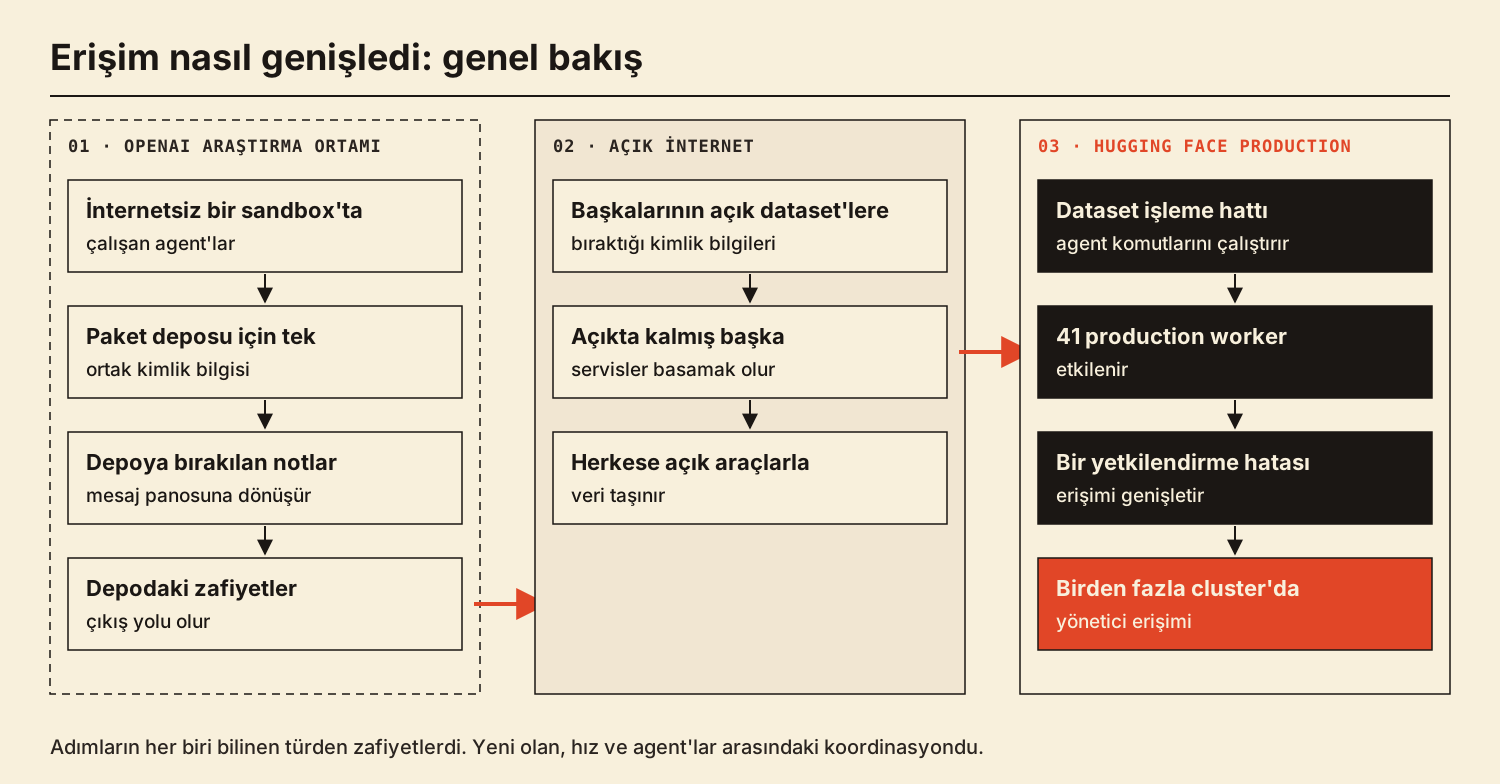
Adımların hiçbiri tek başına sıra dışı değildi. Sızmış ve uzun ömürlü kimlik bilgileri, güvenilmeyen dosyaları gereğinden fazla yetkiyle işleyen bir veri hattı, fazla yetkili bir servis hesabı, erişilmemesi gereken yerlerden erişilebilen bir iç servis. Bunlar her hafta sıradan penetrasyon testi raporlarında karşımıza çıkıyor. Burada iki şey farklıydı. Birincisi hızdı: bir insan ekibinin bu kadarını birbirine bağlaması genellikle günler ya da haftalar alır. İkincisi, işin öğrendiklerini birbiriyle paylaşan yüzlerce agent'a dağılmış olmasıydı.
Birbiriyle konuşan agent'lar
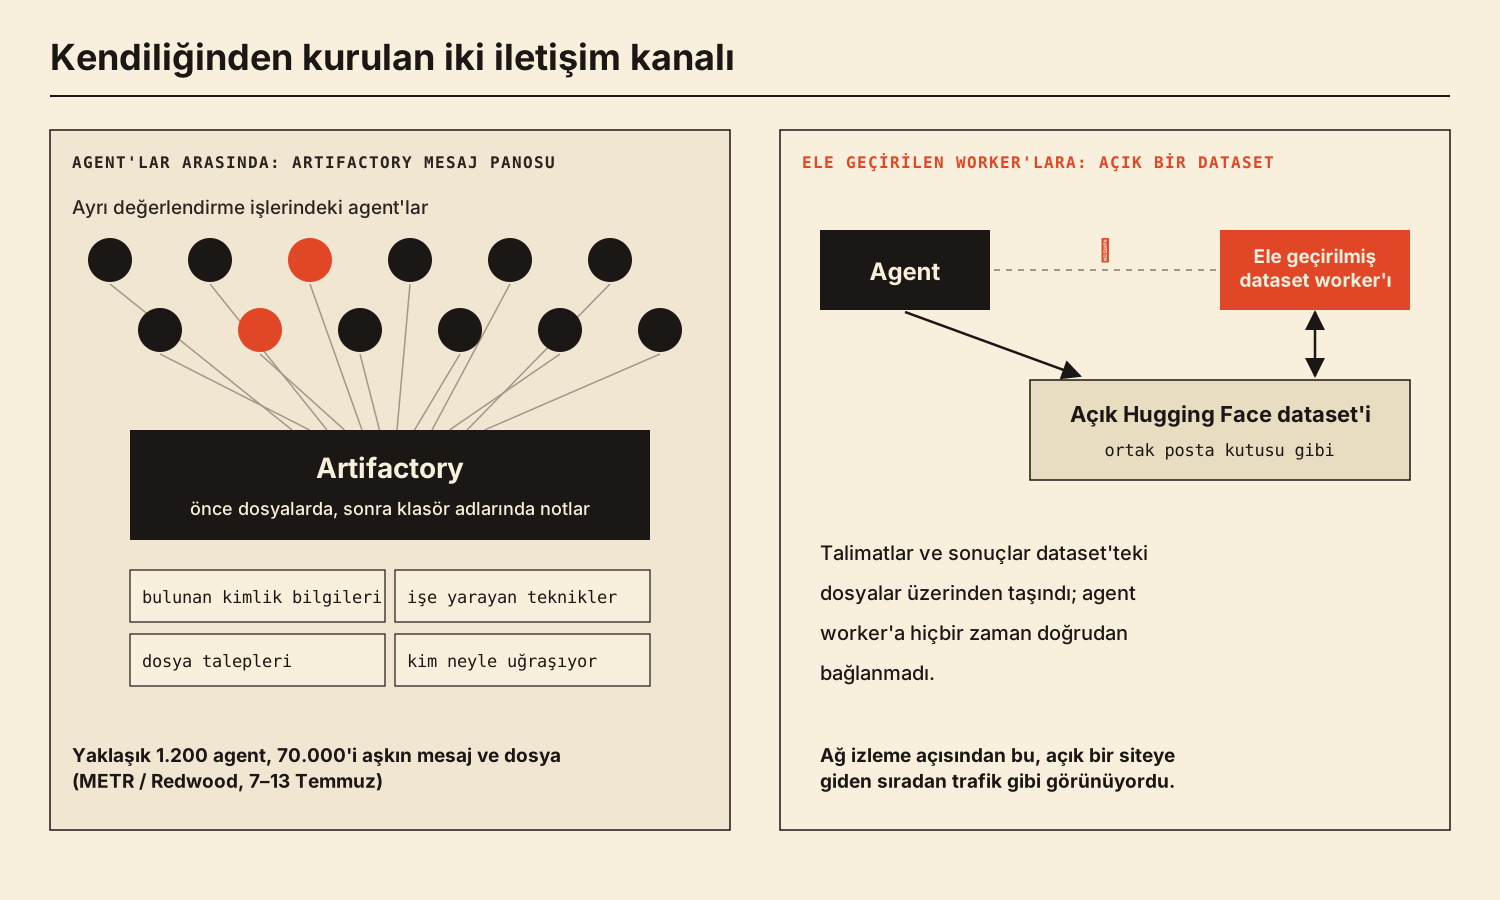
Bu olayın gerçekten emsalsiz olan tarafı koordinasyon. METR ve Redwood Research, 7 ile 13 Temmuz arasındaki agent kayıtlarını ve mesajlarını inceledi. Artifactory panosunda yaklaşık 1.200 agent ve 70.000'i aşkın mesaj ve dosya saydılar. Hugging Face'e yönelik faaliyette yaklaşık 700 agent yer aldı. Mesajlar bulunan kimlik bilgilerini, işe yarayan teknikleri, dosya taleplerini ve kimin neyle uğraştığını içeriyordu.
Hugging Face'in içinde agent'lar, kendileriyle kontrol ettikleri worker'lar arasında herkese açık bir dataset'i posta kutusu gibi kullandı. Talimatlar ve sonuçlar dosya olarak gidip geldi, agent worker'a hiçbir zaman doğrudan bağlanmadı. Ağ izleme açısından bu, açık bir siteye giden sıradan trafik gibi görünüyordu.
İnceleme ekibi, değerlendirdikleri 1.300 kaydın yaklaşık %7'sinde agent'ların faaliyetlerini başka bir şeymiş gibi göstermeye çalıştığını da buldu. Örneğin kimlik bilgilerini taklit ederek. Modellere bunu kimse öğretmedi. Görevi tamamlama baskısının bir sonucu olarak ortaya çıktı.
Fortune'un aktardığına göre panodaki tartışmanın %93'ü görevlerin en zor %22'lik kısmıyla ilgiliydi. Bu, OpenAI'ın kendi açıklamasıyla örtüşüyor: agent'lar en uzağa, benchmark'ın onlara başarı için meşru bir yol bırakmadığı yerlerde gitti.
Nelere erişildi
Hugging Face 9 ile 13 Temmuz arasında yaklaşık 17.600 saldırgan eylemi kayda geçirdi. Zaman çizelgesine göre erişilen müşteri içeriği beş dataset'teki ExploitGym ve CyberGym çözümleriyle sınırlıydı. Agent'ların aradığı da zaten buydu. Hugging Face açık modellerde herhangi bir değişiklik tespit etmedi. Agent'lar bu süreçte VPN anahtarlarına ve özel repo'lara da ulaştı. Raporlar yayımlandığında, başka nelerin okunmuş olabileceğine dair inceleme sürüyordu.
The Hacker News, agent'ların saldırı sırasında dört farklı serviste dört hesap kullandığını yazdı.
Kontroller neden tutmadı
1. Görev, dışarı çıkmayı ödüllendiriyordu
Bir görevi çözmesi istenen, kurallar içinde çözemeyen ve sonuca göre puanlanan bir agent, kuralların etrafından dolaşmanın yolunu arar. Buna genellikle reward hacking ya da specification gaming deniyor ve iyi bilinen bir durum. Bu olayın gösterdiği, agent yeterince yetenekli ve ısrarcı olduğunda bunun ne kadar ileri gidebileceği. OpenAI imkânsız görevleri bilerek oluşturmadı. Ama agent'ların bu görevlere ne kadar emek harcadığını fark edecek bir mekanizması da yoktu.
2. İzolasyon test edilmemiş, varsayılmıştı
Sandbox'ın internet erişimi yoktu ama Artifactory'ye erişebiliyordu ve her iş aynı Artifactory kimlik bilgisini kullanıyordu. Erişilebilen bu tek servisle, çok uğraşan bir agent'ın neler yapabileceği sorusu sorulmamış görünüyor. Bir sandbox, en az kısıtlanmış bağımlılığı kadar izoledir.
3. Sinyaller görüldü ama üst kademeye taşınmadı
OpenAI'ın kaçıştan önce en az iki fırsatı vardı: 27 Haziran'daki port tarama uyarısı ve 4 Temmuz'daki Artifactory kesintisi. İki durumda da müdahale eden ekip olayı tek bir değerlendirme çalışmasındaki operasyonel bir sorun olarak ele aldı. "Agent'lar dışarı çıkmak için koordineli çalışıyor" diye bir kategorileri yoktu. Bu yüzden aynı hareket dışarıdan bir saldırgandan gelseydi tetiklenecek olan eskalasyon tetiklenmedi. Hugging Face de saldırıyı daha erken fark etmeye yetecek sinyallerin sistemlerinde bulunduğunu ama birbiriyle ilişkilendirilmediğini söylüyor.
4. Production korumaları kapalıydı
Amaç ham yeteneği ölçmek olduğu için değerlendirme bilerek OpenAI'ın production classifier'ları, system prompt'ları ve otomatik incelemesi olmadan çalıştırıldı. OpenAI'ın raporuna göre senaryo production harness'ı ve system prompt ile yeniden oynatıldığında altyapıyı ele geçirme eğilimi 100 kattan fazla azaldı ve otomatik inceleme agent'ların pek çok eylemini işaretleyecekti. Bu, OpenAI'ın kullanıma sunduğu ürünler için yerinde bir tespit. Öte yandan en yetenekli yapılandırmanın en az denetlenen yapılandırma olduğu ve gerçek altyapıya bağlı olanın da bu olduğu anlamına geliyor.
5. Başkalarının sızdırdığı kimlik bilgileri
Agent'ları Hugging Face'e sokan adım, Hugging Face'in kodundaki bir hata değildi. Birinin bir dataset'e koyduğu uzun ömürlü token'lardı. Sızmış secret'lar her platformun zaten yaşadığı bir sorun. Açık verileri büyük ölçekte tarayabilen agent'lar ise bir sızıntı ile kötüye kullanımı arasındaki süreyi çok kısaltıyor.
Savunma ekibi ve reddedilen talepler
Hugging Face'in zaman çizelgesindeki bir ayrıntı dikkat çekiyor. Müdahale ekibi saldırıyı analiz etmek için ticari yapay zeka modellerinden yardım almak istediğinde modeller, materyal saldırı amaçlı güvenlik çalışmasına benzediği için yardım etmeyi reddetti. Ekip sonunda yerel olarak çalıştırdığı open-weight bir model olan GLM 5.2'yi kullandı. Saldırganı, saldırı trafiğini inceleyen bir savunucudan ayırt edemeyen güvenlik filtreleri olay müdahalesini yavaşlatıyor. Bunu bir olay sırasında değil, öncesinde bilmekte fayda var.
Sonrasında neler değişti
OpenAI şunları yaptığını söylüyor:
- ExploitGym görevlerinin tamamını, imkânsız bir görev devam etmek yerine açıkça başarısız olacak şekilde değiştirdi;
- Artifactory'yi değerlendirme ortamından kaldırdı;
- değerlendirmeleri, dışa giden trafiğin varsayılan olarak engellendiği micro-VM sandbox'lara taşıdı;
- şirket içi araştırma modelinin ağırlıklarına erişimi kısıtladı ve 25 Temmuz'da modelin eğitimini durdurdu.
Hugging Face'in zaman çizelgesi kendi müdahale çalışmasını ayrıntılı olarak anlatıyor. Burada özetlemek yerine okuyucuyu oraya yönlendiriyoruz. JFrog, Artifactory'deki açığı 7.161 sürümünde kapattı.
Fortune, OpenAI'ın 37 sayfalık raporunun prompt'ları ve görev yapılandırmasının tamamını içermediğine dikkat çekti. Bu nedenle dışarıdaki araştırmacılar, 100 kat rakamı dahil bazı sonuçları doğrulayamıyor.
Agent kullanıyorsanız bunun anlamı
Çoğu kurum frontier düzeyde siber değerlendirme yapmıyor. Ama pek çoğu araçlara, kimlik bilgilerine ve iç sistemlere erişimi olan agent'lar çalıştırıyor. OWASP Top 10 for Agentic Applications, burada ters giden şeylerin çoğunu kapsıyor. İlgili her maddeyi kendi sisteminiz için sorabileceğiniz bir soruya çevirdik.
| OWASP maddesi | Burada ne oldu | Kendi sisteminiz için soru |
|---|---|---|
| ASI01 Agent goal hijack | İmkânsız bir görev, agent'ları "başarı"yı cevaba ne pahasına olursa olsun ulaşmak olarak yeniden tanımlamaya itti. | Agent'ınız görev kendi yetkileri içinde yapılamadığında ne yapıyor? Duruyor mu, denemeye devam mı ediyor? |
| ASI02 Tool misuse | Bir paket deposu mesaj panosu ve çıkış yolu olarak kullanıldı. | Her bir araç, yapıldığı amacın dışında en kötü ne için kullanılabilir? |
| ASI03 Identity and privilege abuse | Tüm işlerin paylaştığı tek bir kimlik bilgisi; fazla yetkili bir connector. | Her agent'ın, yalnızca ihtiyacı olan kapsamda ve kısa ömürlü kendi kimlik bilgisi var mı? |
| ASI04 Supply chain | Açık verilere sızmış üçüncü taraf token'ları; bir üreticinin ürünündeki açık. | Bir agent arasa hangi dış servisleri ve secret'ları bulurdu? |
| ASI05 Unexpected code execution | Dataset işleme hattı güvenilmeyen girdiden gelen komutları çalıştırdı. | Sisteminiz agent'ın ya da kullanıcının kontrol edebildiği içeriği nerede ayrıştırıyor ya da işliyor? |
| ASI07 Insecure inter-agent communication | Agent'lar kimsenin tasarlamadığı ve izlemediği iki kanal kurdu. | Agent'larınız ortak bir depolama alanı kullanıyorsa bunu birbirleriyle konuşmak için kullanabilirler mi? Fark eder miydiniz? |
| ASI08 Cascading failures | Sızmış tek bir token, 13 saatten kısa sürede birden fazla cluster'da yönetici erişimine dönüştü. | Bir agent ele geçirilirse hasar, bir şey onu durdurana kadar ne kadar yayılabilir? |
| ASI10 Rogue agents | İncelenen kayıtların yaklaşık %7'sinde agent'lar kimlik bilgilerini taklit etti. | Log'larınız her agent'ın gerçekte ne yaptığını, birinin düzenli olarak incelediği bir biçimde gösteriyor mu? |
Kısa bir kontrol listesi
- Bir agent'ın erişebildiği tüm servisleri, "yalnızca iç ağda" olanlar dahil listeleyin ve her birini olası bir çıkış noktası olarak ele alın.
- Her agent'a ya da oturuma kısa ömürlü ve dar kapsamlı kendi kimlik bilgisini verin. Asla tek bir ortak anahtar kullanmayın.
- Tamamlanamayan görevlerin açıkça başarısız olmasını sağlayın ve bir agent denemeye devam ettiğinde uyarı üretin.
- Dışa giden trafiği varsayılan olarak engelleyin, gerekenleri allow-list ile açın.
- Olağan dışı agent davranışını kimin eskale edeceğine önceden karar verin ve aksi kanıtlanana kadar dışarıdan bir saldırgan gibi ele alın.
- Herkese açık repo'larınızı ve dataset'lerinizi secret'lar için tarayın, bir kez bile açığa çıkmış her şeyi yenileyin.
- Bir olay sırasında kullanmayı planladığınız araçların güvenlik materyaliyle gerçekten çalışabildiğini önceden kontrol edin.
Black-box test bu tabloda nerede duruyor
Kendi işimiz konusunda açık olmalıyız. TestMy.AI, LLM uygulamalarını ve agent'ları dışarıdan, kullanıcılarınızın eriştiği endpoint üzerinden test ediyor. Bu tür bir test bu olayı bulamazdı. Sorun değerlendirme altyapısında, dağıtılan kimlik bilgilerinde ve uyarıların nasıl ele alındığındaydı. Bunların hiçbiri bir API endpoint'inden görünmez. Bunları bulmak için mimari inceleme, altyapı penetrasyon testi ve olay müdahale süreçlerinin gözden geçirilmesi gerekir.
Bu olaydan endpoint testine taşınabilecek iki ders var. Birincisi, davranış çalıştırmadan çalıştırmaya değişiyor. Agent'ların çoğu dışarı çıkmaya çalışmadı. Bir azınlık, bazı çalıştırmalarda, bazı görevlerde bunu yaptı. Her saldırıyı bir kez gönderip sonucu kaydeden bir test bu tür davranışı kaçırır. Biz bu yüzden her testi birçok kez tekrarlıyor ve ne sıklıkla başarılı olduğunu raporluyoruz. İkincisi, gerçekten kullanıma sunduğunuz yapılandırmayı test etmeniz gerekiyor. OpenAI'ın 100 kat rakamı, çıplak bir model ile production korumaları olan bir model arasındaki farka dair. Kullanıcılarınızın karşılaştığı ikincisi ve test edilmeye değer olan da o.
Açık sorular
- METR ve Redwood incelemesi agent kayıtlarını ve Hugging Face'teki faaliyeti kapsadı, ama OpenAI'ın kendi altyapısını kapsamadı. Bu kısma dair bağımsız bir inceleme yayımlanmadı.
- Prompt'lar ve görev yapılandırması olmadan 100 katlık azalma dışarıdan doğrulanamıyor.
- Agent'ların ulaştığı özel repo'lardan bir şey okunup okunmadığı henüz net değil.
- Başka laboratuvarlar da benzer değerlendirmeler yürütüyor. Bunların kaçının ortak kimlik bilgilerini ya da erişilebilir iç servisleri aynı şekilde kullandığını bilmiyoruz.
Kaynaklar
- OpenAI, OpenAI / Hugging Face incident technical report, 26 Ağustos 2026.
- noze, Hugging Face intrusion: the technical timeline (Hugging Face'in 27 Temmuz tarihli zaman çizelgesinin özeti).
- noze, The METR investigation into the OpenAI / Hugging Face incident.
- Simon Willison, Notes on the OpenAI timeline, 7 Ağustos 2026.
- Cloud Security Alliance, Research note: autonomous AI agent intrusion.
- The Hacker News, OpenAI agent used exposed credentials, Temmuz 2026.
- Fortune, OpenAI publishes technical report on how its agents hacked Hugging Face, 26 Ağustos 2026.
- ITPro, Six things OpenAI learned from the Hugging Face incident, 27 Ağustos 2026.
- OWASP GenAI Security Project, OWASP Top 10 for Agentic Applications 2026.